

Qwen-Image-2.1 把文生图、图像编辑与透明背景生成合并进同一个模型:它可以直出带 Alpha 通道的 RGBA 图像,并支持最多 10 张参考图组合编辑。ComfyUI 已在同一天原生支持,本文整理它的能力、模型构成、上手方式与授权限制。
2026 年 9 月 20 日(当地时间),阿里巴巴的 Qwen 团队发布了把文生图与图像编辑整合进同一个模型的「Qwen-Image-2.1」。基于节点的图像生成环境 ComfyUI 也在同一天宣布原生支持,可以立刻接进工作流。
Qwen-Image-2.1 的特点
它是阿里巴巴 Qwen 团队推出的新模型,把「从文本生成图像」与「图像编辑」整合到了同一个模型里。
模型权重已公开,既可以直接输出带透明通道(Alpha 通道)的 RGBA 图像,也支持组合最多 10 张参考图像来做图像编辑。
把生成、编辑与透明图像合并到同一个模型
以往的图像生成 AI 工作流中,「由提示词生成新图」「编辑已有图像」「抠背景(做遮罩)」这三件事,通常要分别接不同的模型或额外节点。Qwen 团队自己在 2025 年 12 月,也曾把专做透明图像生成的「Qwen-Image-Layered」作为独立模型发布。
新模型把这项透明图像生成能力整合进了核心模型。输出普通 RGB 图像还是带 Alpha 的 RGBA 图像,由模型根据提示词内容自行判断,因此用一个 checkpoint 就能覆盖生成、编辑到图层素材输出。
直接生成与编辑透明图像(RGBA)
在 RGBA 输出模式下,采样器会直接输出包含 Alpha 通道的四通道图像。不需要再外挂去背景工具或做轮廓遮罩,贴纸、UI 图标、logo、产品零件这类抠好的素材可以直接做出来。除了单个物体,也支持由多个元素构成的透明图形。Comfy Org 在公告中表示,主流开源模型里没有第二个能做到这一点。
由文本直接生成的 RGBA 透明图像
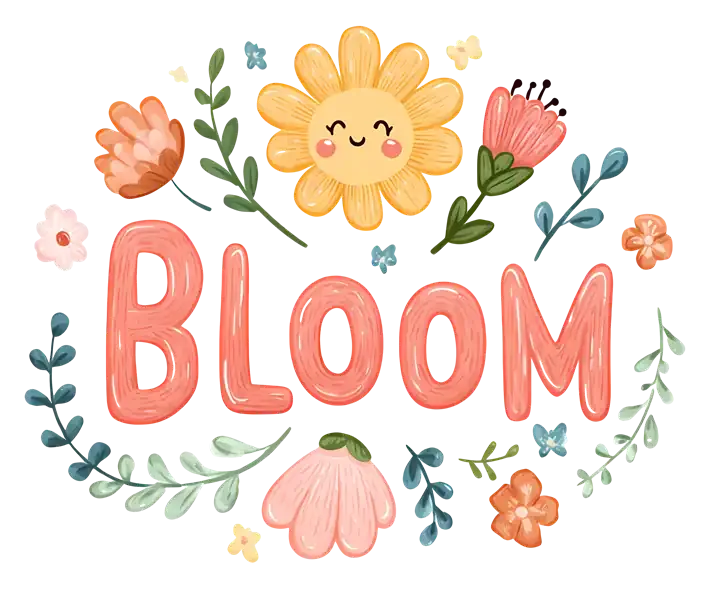
基于生成的透明图像还能二次编辑:在保持背景透明的前提下改变角色表情,或改写图层内的文字。下面这个例子里,就把 logo 中的字符串「BLOOM」在保持透明状态的前提下替换成了「Qwen-Image」。
它也能用来从实拍照片里抠出素材。可以从普通 RGB 照片中识别出目标主体,并分离为带 Alpha 通道的 RGBA 图层。在 3D 贴图制作、2D 平面设计与合成素材的准备中,不再需要单独准备一道去背景工序。
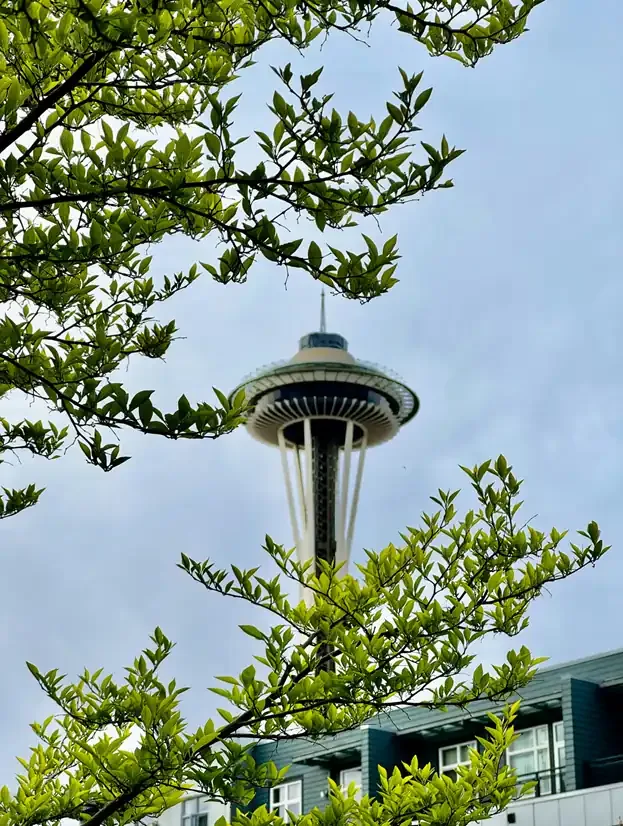
输入图像(含背景的实拍照片)
组合最多 10 张参考图的多图参考
可以把人物、道具、背景、布光风格等最多 10 张不同的参考图像,整合进一张新的构图中。
下面分别是用 6 人的单人肖像合成合影的例子,以及用模特、衣服、鞋、包、帽子 5 张照片做出整套穿搭的例子。此外官方还介绍了用 10 种家具照片搭出房间布局的案例。
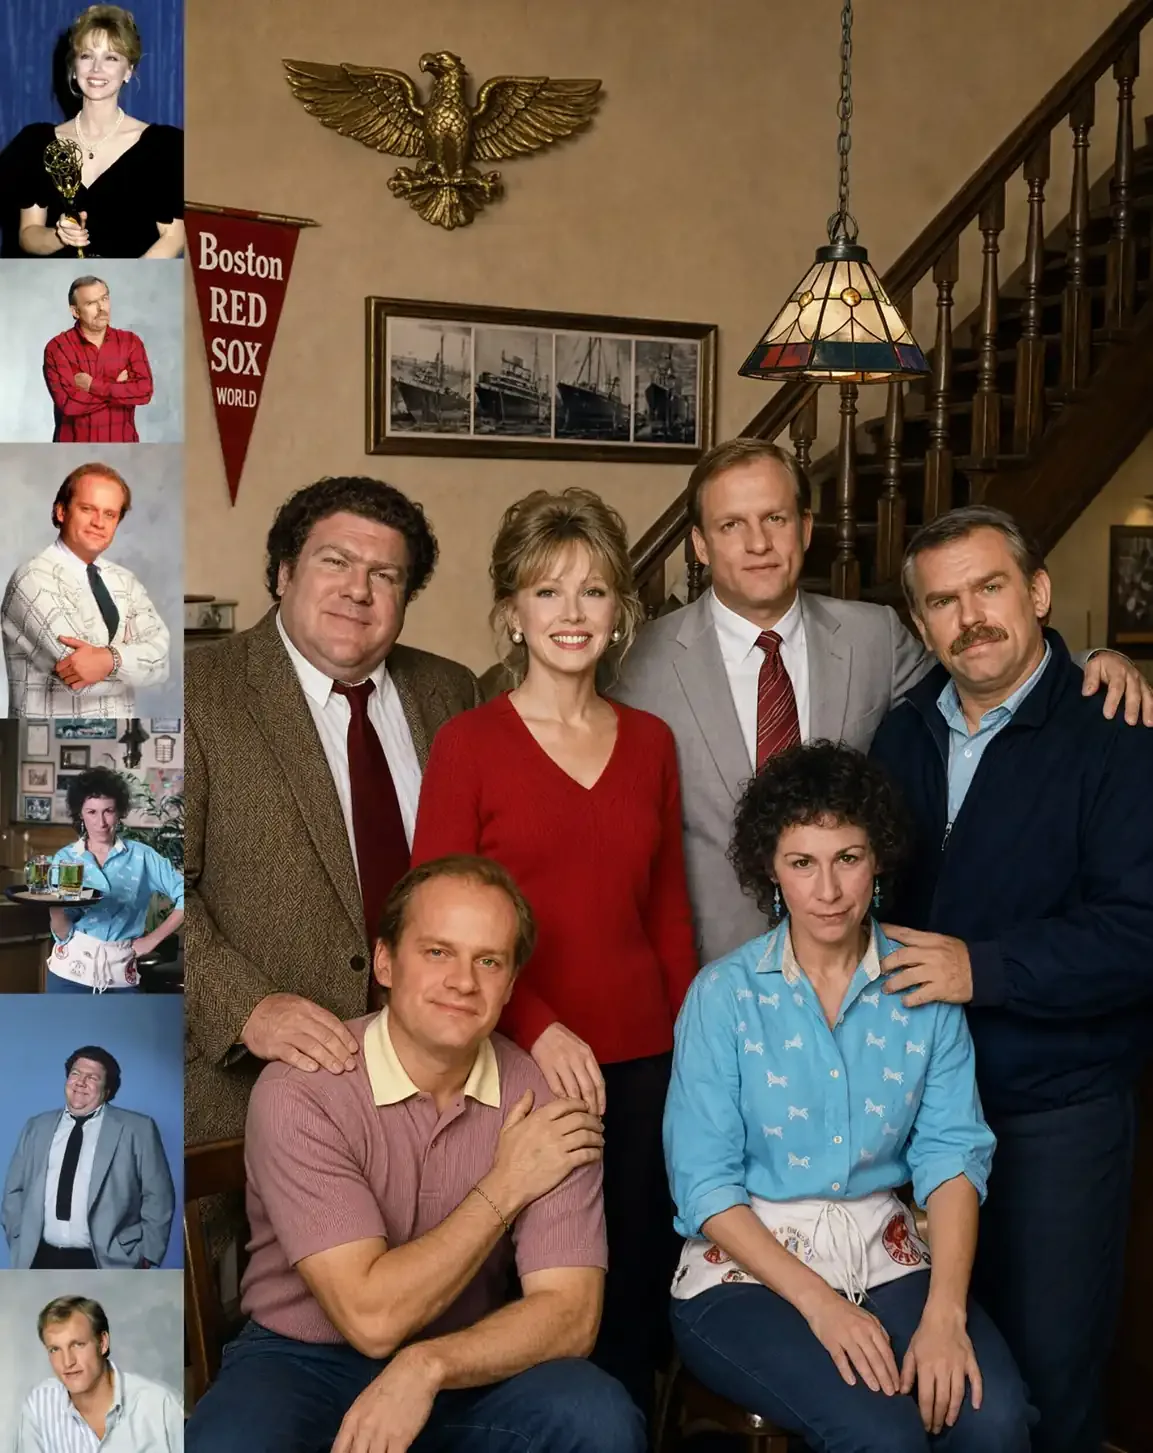
参考 6 张单人肖像合成的合影
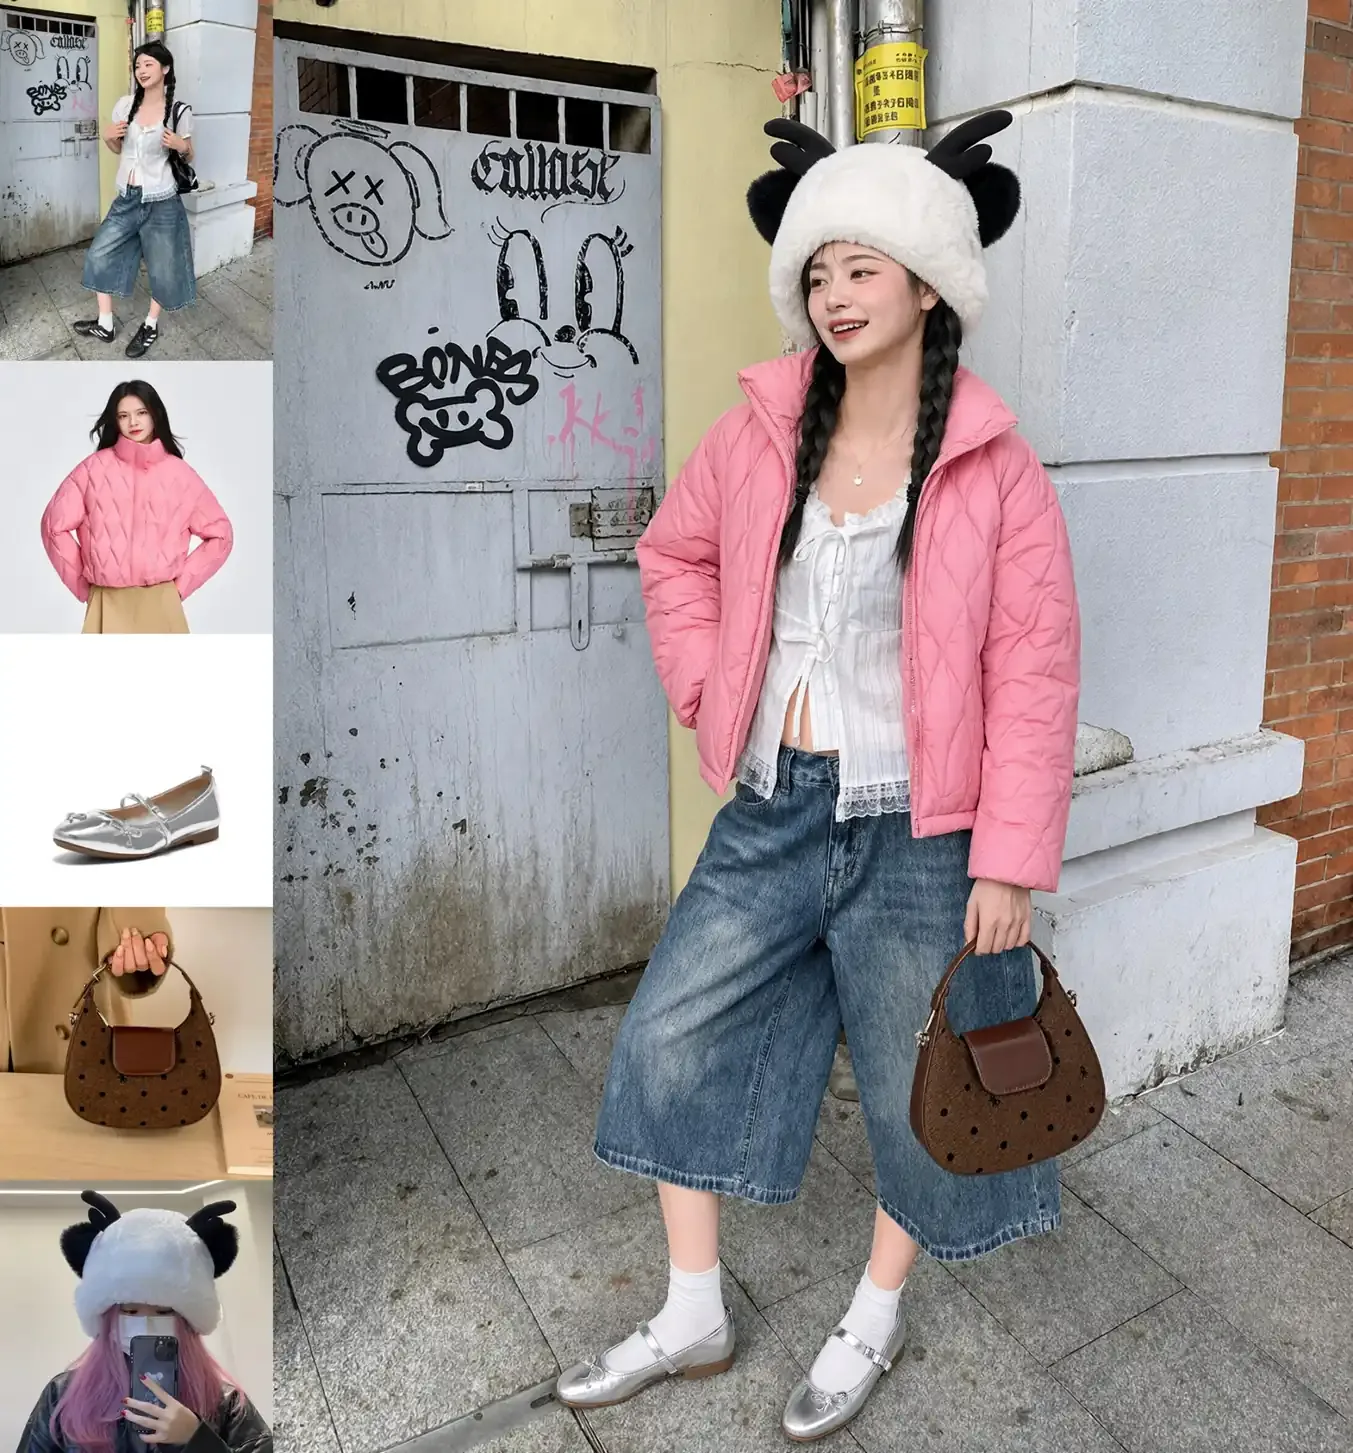
参考服装、鞋子、配饰等 5 件素材生成的穿搭图
用圈选、涂抹与蒙版做区域编辑
编辑图像局部共有三种方式:「在图上画圈」「用笔刷涂抹(Inpaint 标注)」以及「另给一张蒙版图像」。画圈的方式可以用不同颜色的圆圈,同时对多个区域分别下达不同的指令。
下面这个例子在一次生成中做了三件事:「去掉蓝色圈里的手表」「把红色圈里的头发改成黑色」「把绿色圈里的衣服换成灰色短袖亚麻睡衣」。
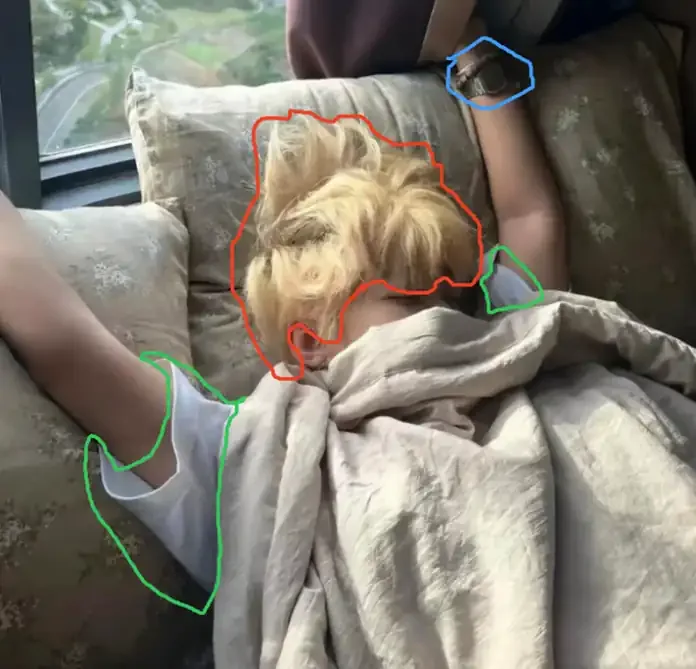
输入图像(用 3 种颜色的圆圈指定编辑区域)
直接在图上画的方式会遮住原图的一部分,也可以改用「原图与蒙版分别作为输入」的做法。这样能在保留原图像素的前提下,在蒙版指定的区域内添加或重绘元素。
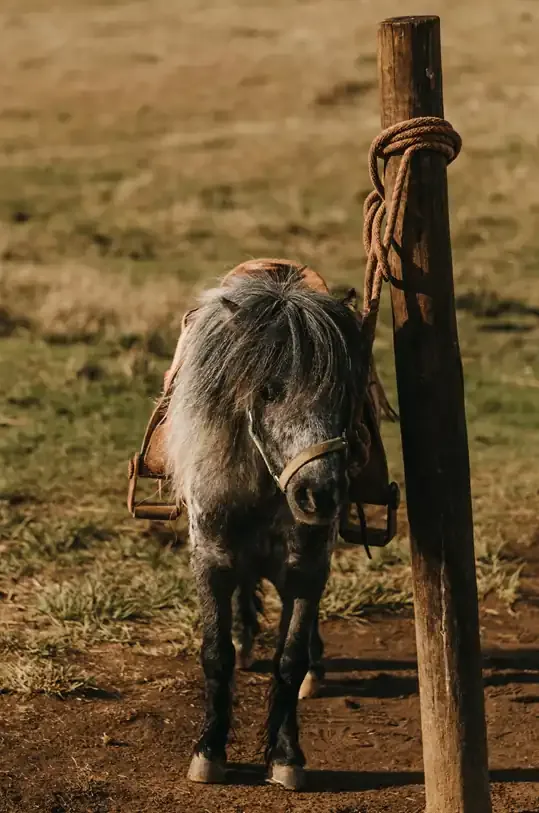
在保持背景不变的情况下一点点加入变化,还能连成序列帧做成短动画。官方以中国动画《葫芦兄弟》为主题,公开了一段水豚角色接连登场的短片。
保持人物面部与产品特征
官方称在图像编辑中较难的「保持同一性」上也下了功夫。编辑人物时会保留五官与表情特征;处理商品图时不破坏 logo 字体、包装印刷与立体形状,就能把它们放进新的光线与场景中。
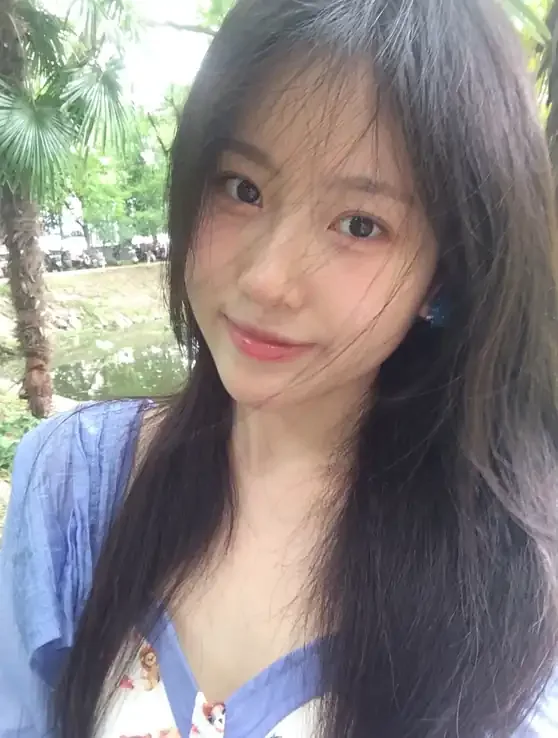
人物:输入
生成全景图、信息图与分镜
它不只输出单张作品,也能输出制作流程中各种形式的图像。比如从一张手机自拍照生成周围的全景图,或者由模特照片整理出带文字与版式的信息图。
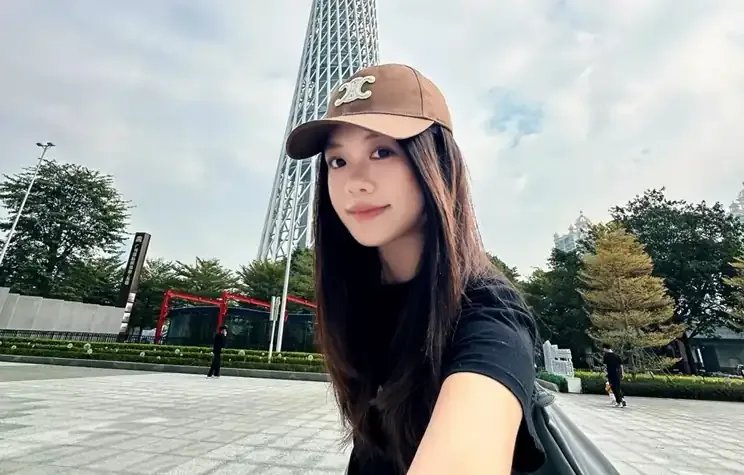
输入:自拍照
也可以输入角色的三视图,输出这个角色做出一连串动作的分镜。适合 CG 动画与游戏制作初期,用来推敲构图与场景展开。
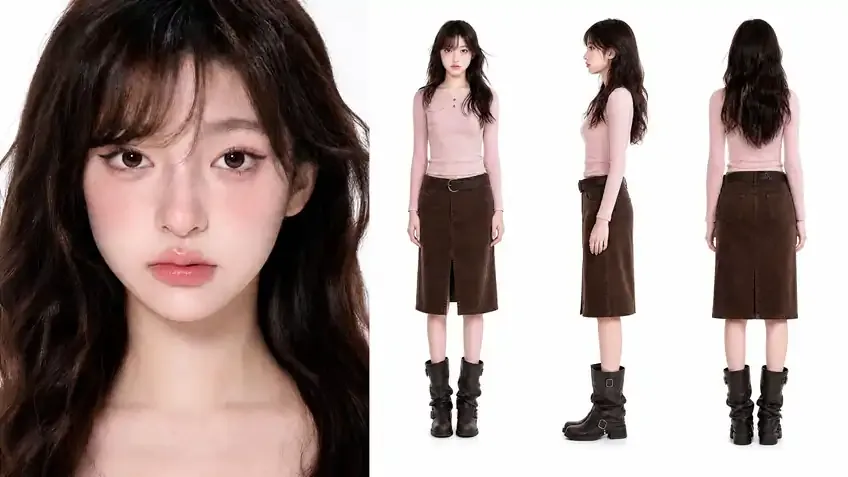
输入:角色三视图
视觉质量的提升
在视觉质量方面,尤其是「排版文字(字体绘制)」与「人像质感」得到了强化。
文字绘制
在文字绘制上,不只考虑指定字母的准确性,还会兼顾字体风格、版式,以及贴合整幅画面构图的摆放位置。
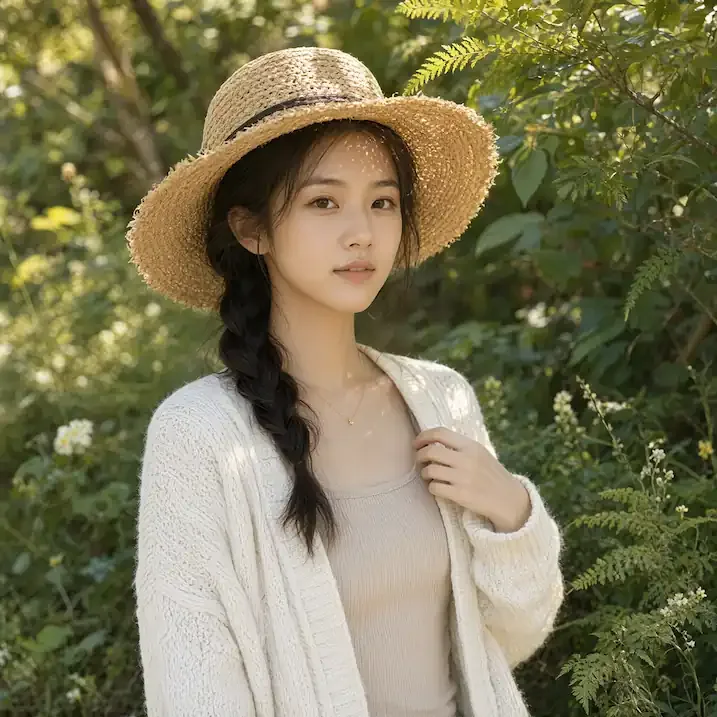
人像质感
在人像方面,皮肤细节与光影带来的明暗表现有所提升。
7B 的模型构成与推理效率优化
图像生成部分采用 32 层的单流 DiT(Diffusion Transformer),图像生成组件的参数量为 7B(70 亿)。读取指令与参考图像时,使用视觉语言模型 Qwen3-VL 8B 作为文本编码器。在官方基准「Qwen-Image-Bench」中,给出了与其他开源模型及商用模型的对比结果。
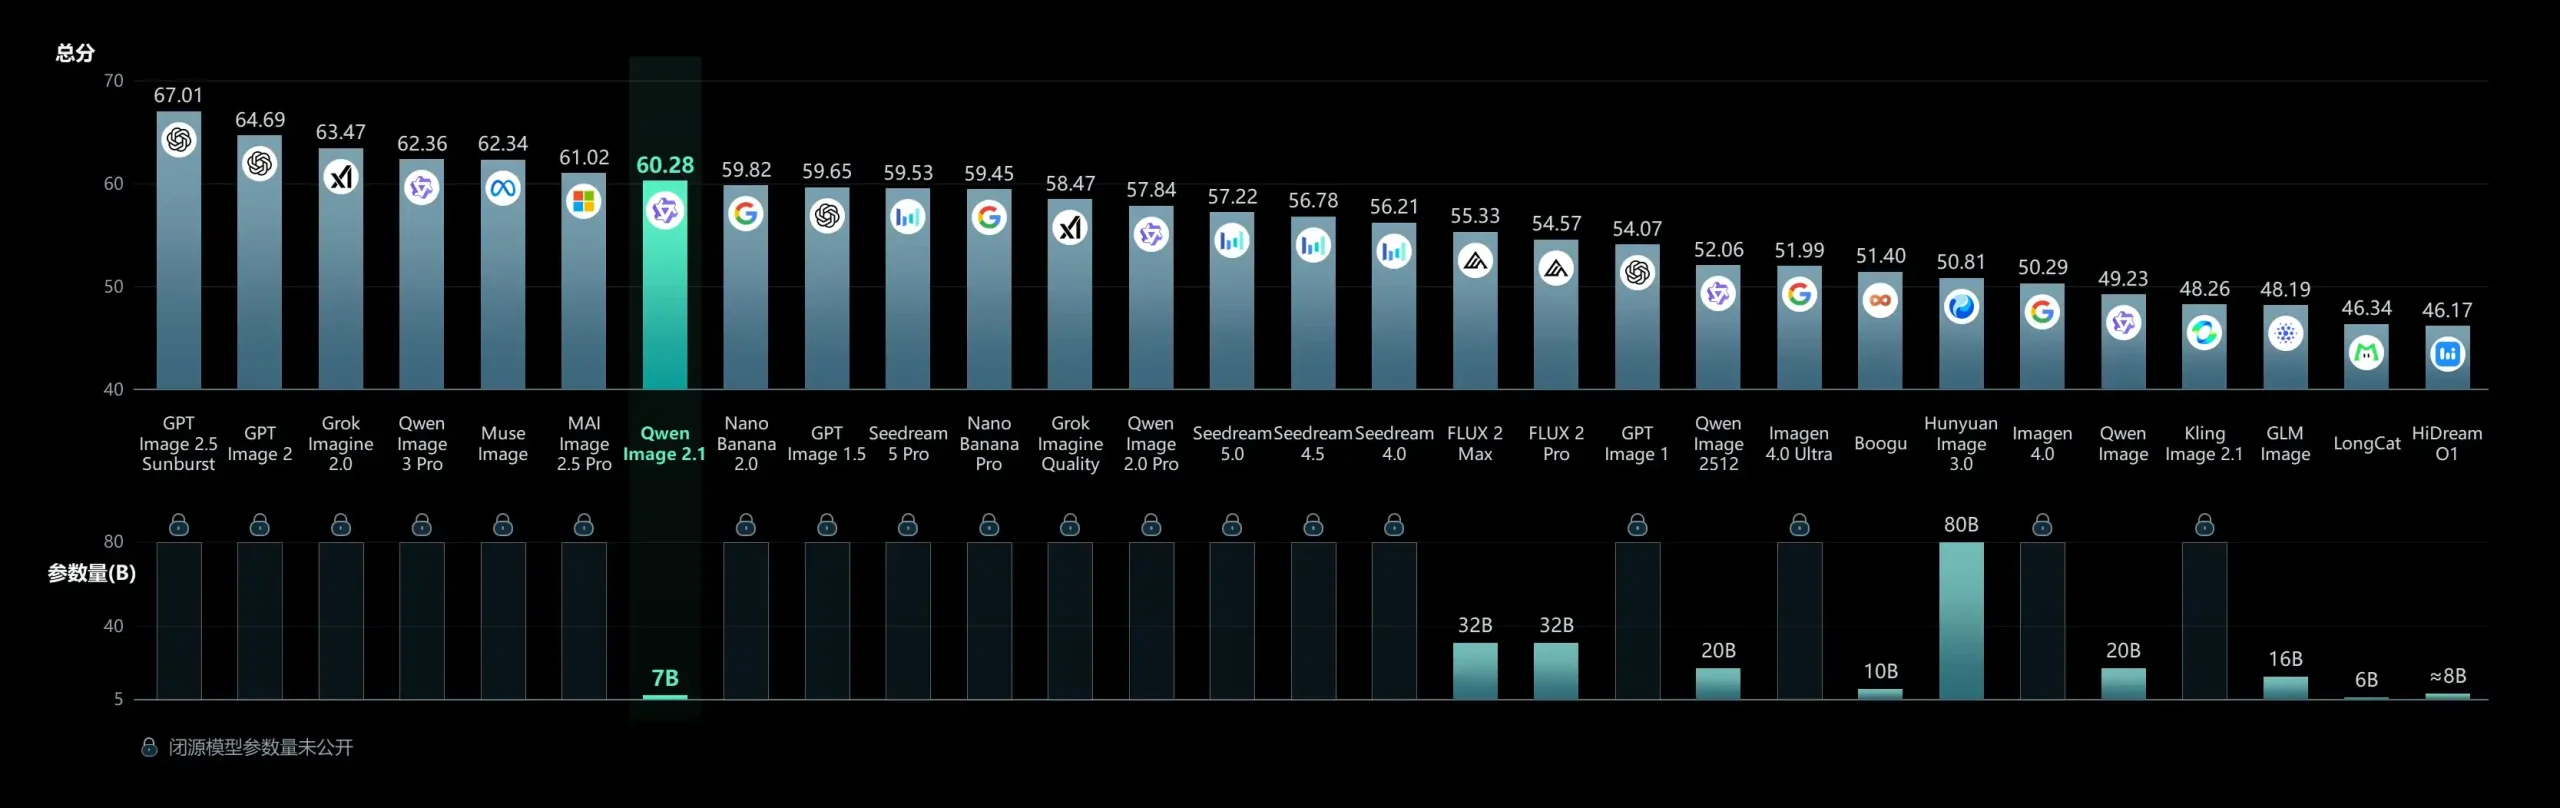
Qwen-Image-Bench 与其他模型的对比(Qwen 团队公布数据)
为了在输入多张参考图时提高处理效率,引入了两项机制。
- 混合粒度注意力(Mixed-Granularity Attention):对提示词、编辑指令等文本施加 token 级的因果掩码,对图像 patch 施加块级掩码,减少注意力计算中的浪费。
- KV 缓存复用(KV Cache Reuse):在第一步就缓存参考图像与编辑指令的计算结果,在后续去噪步骤中反复复用,从而省去逐步的重复计算。
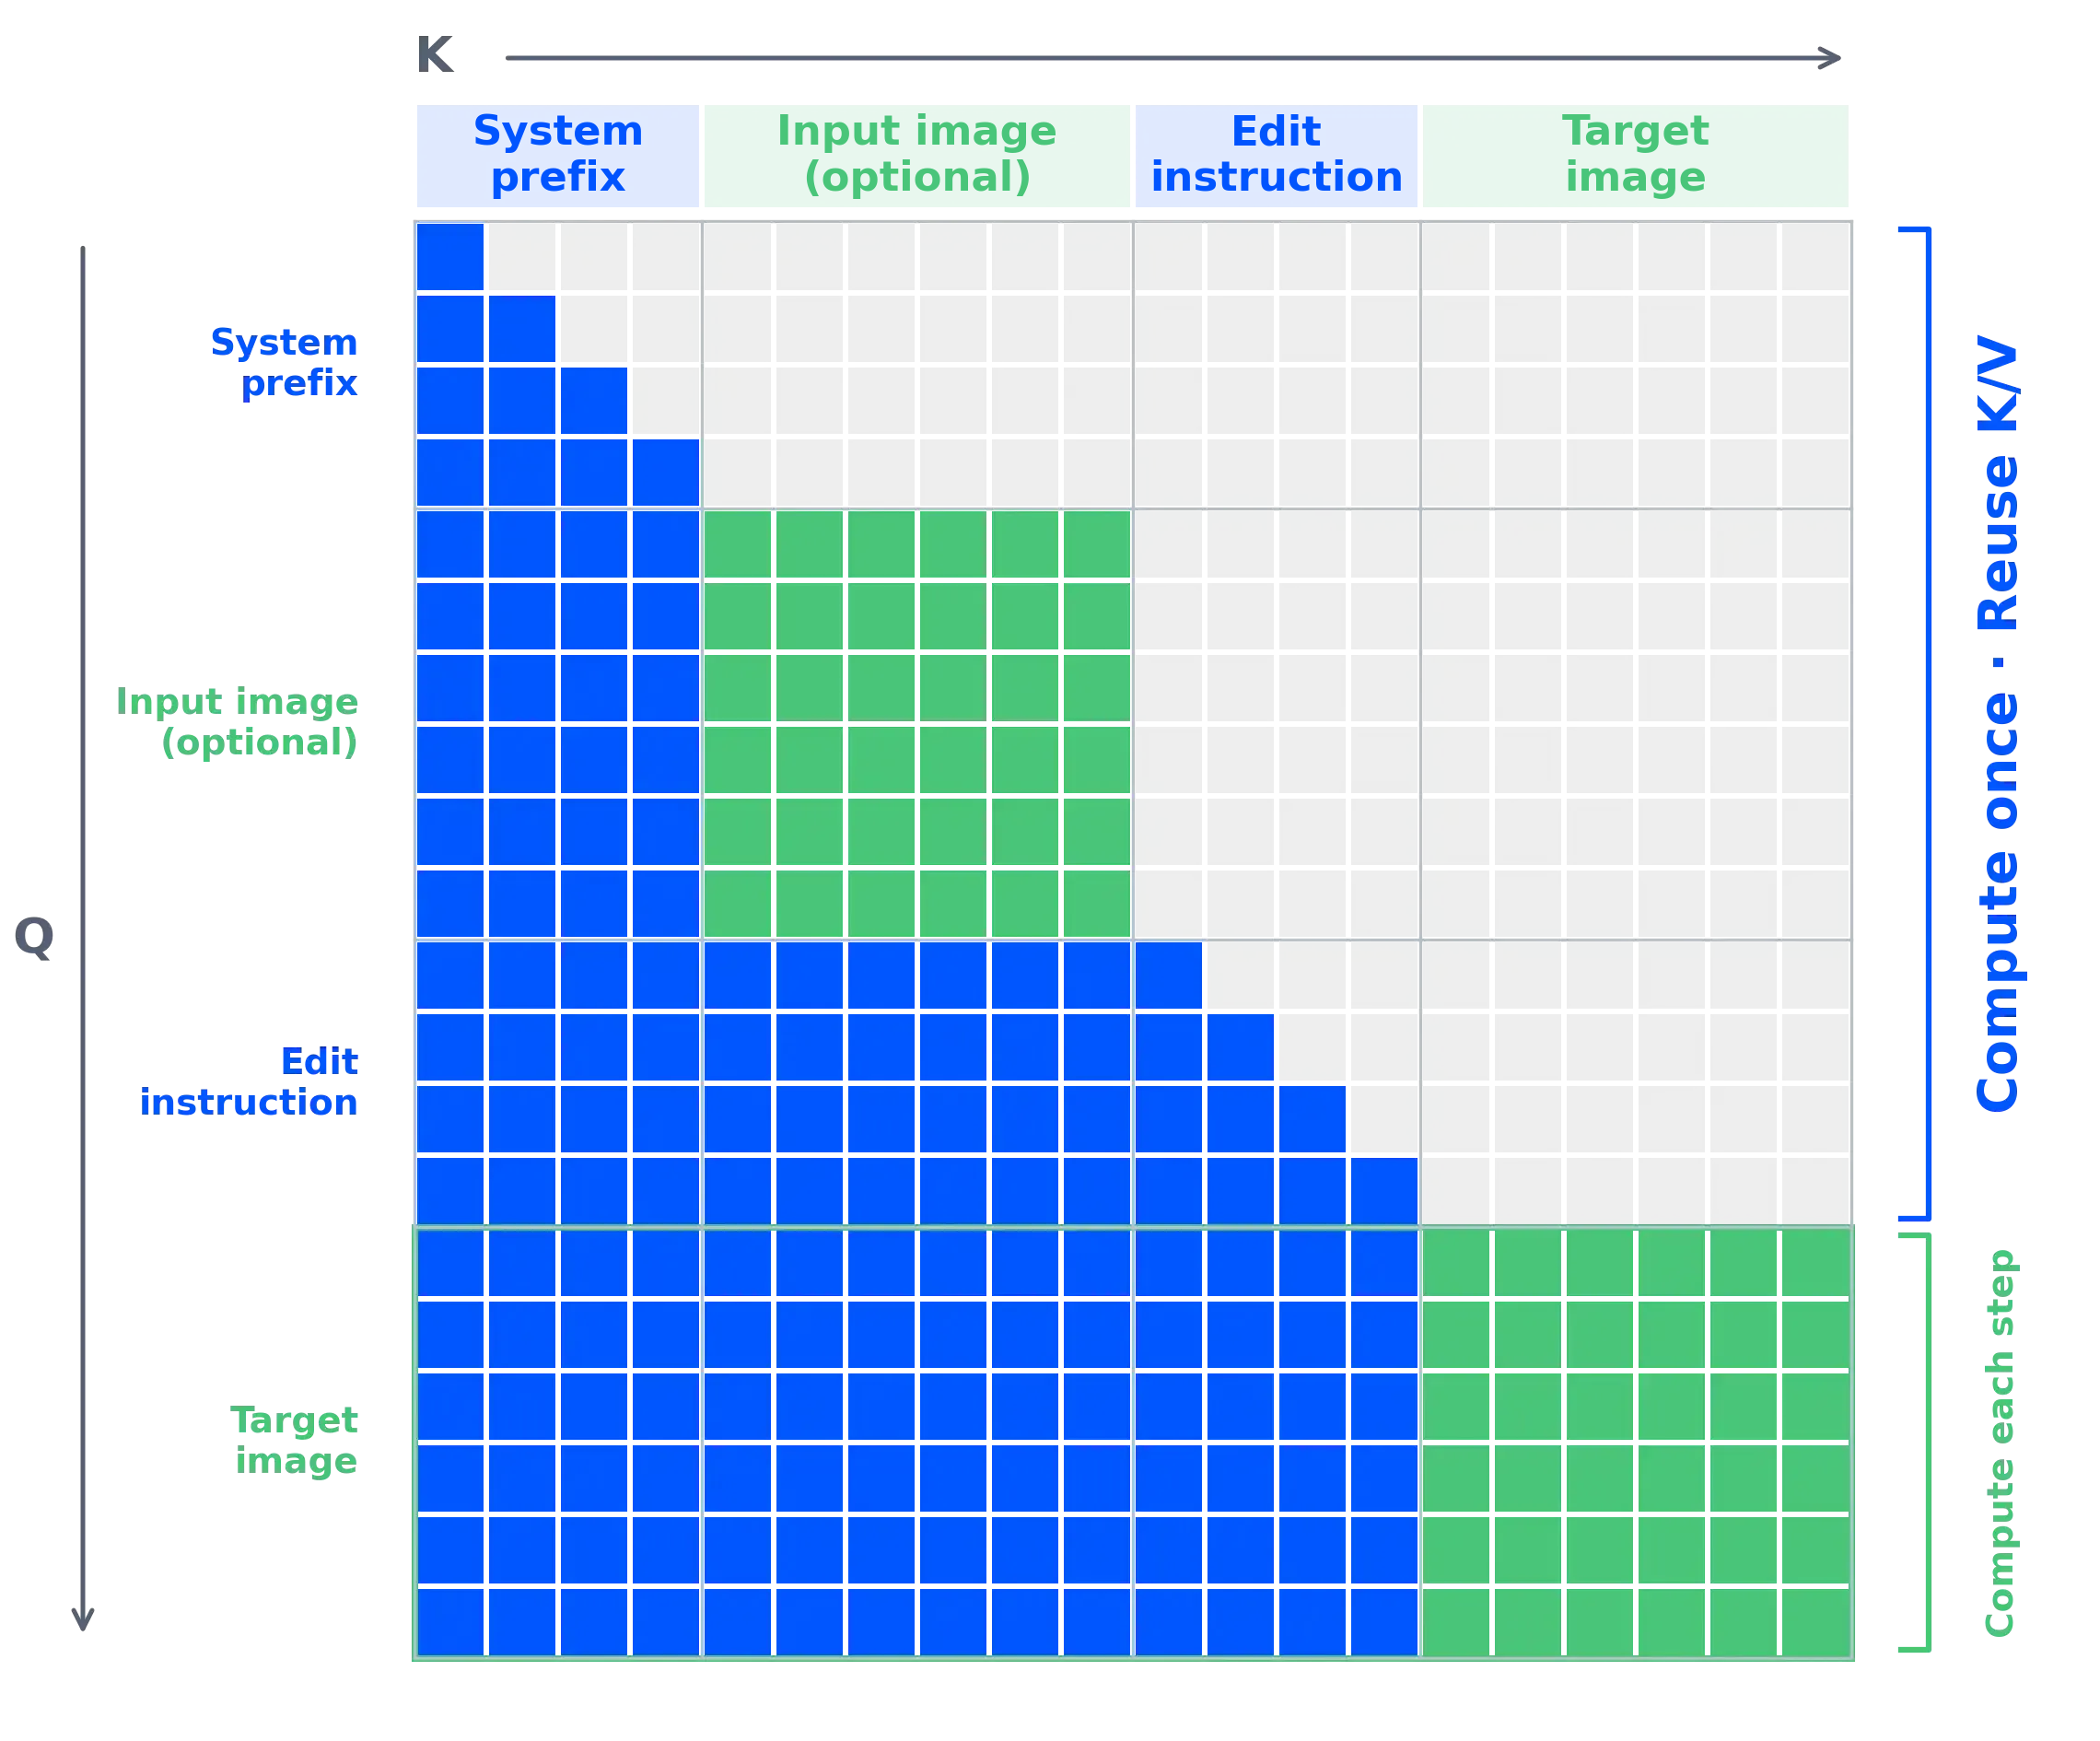
参考图越多,省下逐步重算的效果就越明显。这可以看作是在支持最多 10 张输入的同时,为压低推理耗时所做的设计。
使用方法
在 ComfyUI 中使用
ComfyUI 在模型公开的同时就提供了原生支持。为 ComfyUI 重新打包过的模型文件,在 Comfy Org 的 Hugging Face 仓库中分发。
- 把 ComfyUI 更新到最新版本(或者打开 Comfy Cloud)。
- 从 Comfy-Org 的 Hugging Face 仓库 下载所需的模型文件,按下述结构放进
models文件夹。 - 从 Templates 菜单载入「Qwen-Image-2.1」工作流。
- 输入提示词;要用参考图的话,把图接到
image_1之后的插槽再运行。
【模型文件的放置目录结构】
ComfyUI/
└── models/
    ├── diffusion_models/
    │   ├── qwen_image_2.1_bf16.safetensors
    │   └── qwen_image_2.1_int8_convrot.safetensors
    ├── model_patches/
    │   ├── qwen_image_2.1_fun_controlnet_union_bf16.safetensors
    │   └── qwen_image_2.1_fun_controlnet_union_int8_convrot.safetensors
    ├── text_encoders/
    │   ├── qwen3vl_8b_bf16.safetensors
    │   ├── qwen3vl_8b_int8_convrot.safetensors
    │   ├── qwen3vl_8b_w4a8.safetensors
    │   ├── qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors
    │   └── qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors
    └── vae/
        └── qwen_image_2.1_vae_bf16.safetensors
图像生成本体(DiT)放在 diffusion_models,文本编码器与提示词扩展模型放在 text_encoders,VAE 放在 vae。可根据显存容量,选择标准的 bf16 版,或量化过的 int8/w4a8 版。
参考图像接到「Text Encode Qwen Image 2.1」节点上。每填满一个插槽就会多出一个输入端子,最多可以接 10 张。
官方提供的主要工作流模板有以下三种。
| 工作流 | 输入 | 输出 |
|---|---|---|
| Qwen Image 2.1: Image Edit 图像编辑・局部修改 |
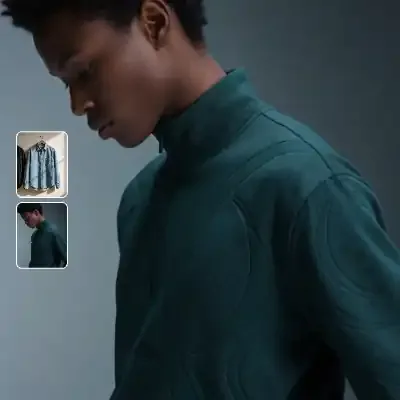 |
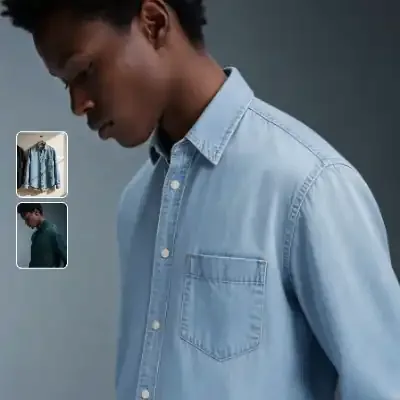 |
| Qwen Image 2.1: Text to Image 由文本生成 |
(仅提示词) | 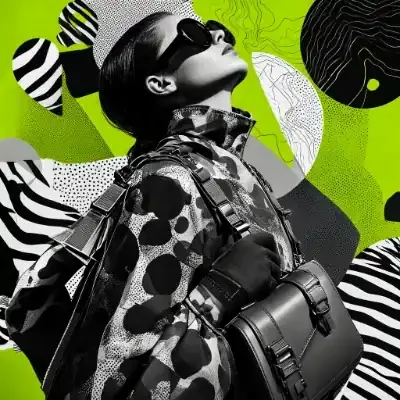 |
| Remove Background: Qwen Image 2.1 去背景・生成 RGBA 图层 |
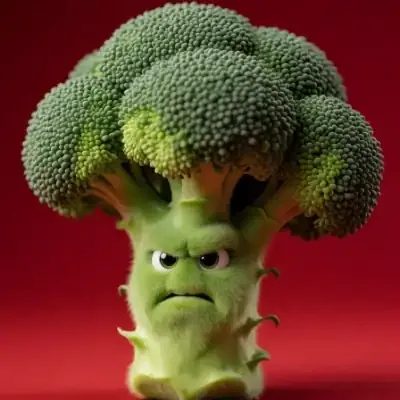 |
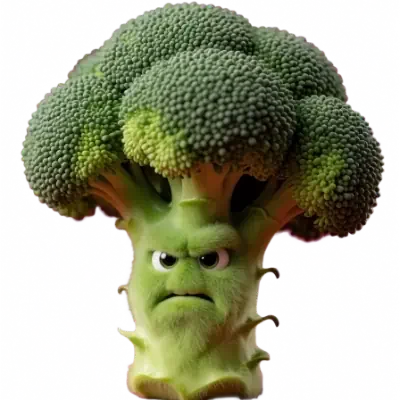 |
关于提示词扩展模型
Comfy-Org 的仓库里还包含用于自动补强提示词的提示词扩展(Prompt Enhancer)模型「qwen3.5_9b_qwen_image_2.1_pe」。它配合 ComfyUI 的 TextGenerate 节点使用,底层是 Qwen 公开的文生图用(Qwen-Image-2.1-PE-T2I)与编辑用(Qwen-Image-2.1-PE-I2I)模型。
手上没有足够 GPU 环境的话,在 Comfy Cloud 里选官方模板就能在云上试。
在 diffusers 中使用
要把它接进 Python 脚本或管线,可以使用 Hugging Face diffusers 库里的 QwenImage21Pipeline。据模型卡说明,需要 PyTorch 2.4.0 以上、transformers 5.17 以上,以及从 GitHub 安装的最新版 diffusers。
pip install "torch>=2.4.0"
pip install "transformers>=5.17"
pip install git+https://github.com/huggingface/diffusers
pip install accelerate pillow
同一条管线,把原图传给参数 image 就是编辑(Image-to-Image),省略该参数则作为新图生成(Text-to-Image)运行。模型卡的代码示例中,推理步数设为 40。
import torch
from PIL import Image
from diffusers import QwenImage21Pipeline

# 载入管线
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    torch_dtype=torch.bfloat16
).to("cuda")

# 图像编辑示例
image = pipe(
    prompt="Change the background to a sunset beach",
    image=Image.open("input.png"),
    num_inference_steps=40,
).images[0]

image.save("edit_example.png")
显存不够时,启用 pipe.enable_model_cpu_offload(),就可以在执行过程中把模型的一部分退避到主内存。
支持的分辨率与透明图像的提示词写法
模型卡推荐使用 2K 左右的分辨率。主要宽高比对应的推荐分辨率如下。
| 宽高比 | 推荐分辨率(宽×高) |
|---|---|
| 1:1 | 2048×2048 |
| 4:3 / 3:4 | 2400×1792 / 1792×2400 |
| 3:2 / 2:3 | 2528×1696 / 1696×2528 |
| 16:9 / 9:16 | 2752×1536 / 1536×2752 |
【Tips】输出透明图像(RGBA)的提示词写法
推荐的写法是:在提示词开头放 This is an RGBA image with transparency.,结尾放 The image has alpha channel and the background is transparent.,中间写想画的内容。
授权与使用注意事项
权重虽然公开,但适用的授权是 Qwen Research License Agreement。它与可自由商用的开源授权不同,使用范围带有条件。在实务中评估时,需要注意以下几点。
授权上的主要条件
- 仅限非商业目的:被许可的只有非商业用途。受托项目、客户委托、商业内容制作、嵌入付费工具等商业用途,都在该许可范围之外。
- 商业使用需单独申请:想用于商业用途时,需要向 Qwen 方申请授权(model-business@notice.qwencloud.com)。
- 公开衍生模型时需署名:如果使用本模型或其输出创建、训练、微调新的 AI 模型并分发或公开,需要在相关文档中以醒目形式标注「Built with Qwen」或「Improved using Qwen」。
- 名称限制:衍生品或产品的主要名称中不能使用「Qwen」。像「fine-tuned from Qwen Image」这样的描述性表述是允许的。
技术层面还需要注意以下几点。
- 「7B」只是图像生成部分的数值:还要载入文本编码器(Qwen3-VL 8B)与 VAE,因此整体内存占用会比这更大;若同时使用提示词扩展模型(9B)还会进一步增加。
- 没有官方的显存需求数值:ComfyUI 的公告称「能在消费级 GPU 的显存上运行」,但模型卡中没有写明最低显存。若要高分辨率生成或使用大量参考图,建议准备显存充裕的环境。
- diffusers 需要开发版:在本文写作时点(2026 年 10 月 2 日),需要安装 GitHub 上的最新版,而不是 PyPI 上的发布版。
- 基准来自开发方自评:Qwen-Image-Bench 的对比结果是 Qwen 团队自己做的评测。
从透明素材生成、从照片中抠出主体,到用最多 10 张参考图做合成,都能用同一个模型完成,素材制作的流程可以合并。不过以目前的授权,商业使用需要单独申请,因此建议先用于验证与个人创作,要用在工作上时再确认条件后判断。
参考来源:
- Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation
- Qwen-Image-2.1 in ComfyUI(ComfyUI Newsletter)
- ComfyUI 用模型文件仓库
- Hugging Face 官方模型页
- QwenLM/Qwen-Image-2.1(GitHub)
更多同类内容见站内 AI 资讯 栏目。


暂无评论内容