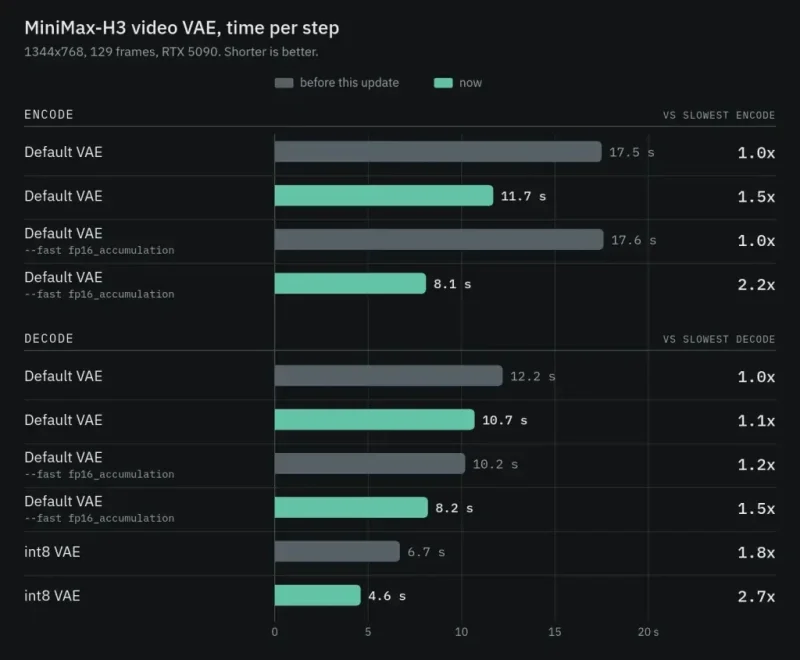


MiniMax H3 的视频 VAE 在 ComfyUI 侧完成了一次提速:编码最高约 2.2 倍、解码约 1.4〜2.7 倍。本文整理这次改动的三处实现细节、官方实测数据,以及对画质的影响。
2026 年 9 月 22 日(当地时间),Comfy Org 在官方博客上宣布,已对 ComfyUI 中运行的视频生成模型的视频 VAE 完成提速。
MiniMax H3 提速
该模型拥有 33B 参数,属于多模态模型,可以同时参照文本、图像、视频与音频,生成带声音的视频。ComfyUI 在它发布当天就提供了原生支持,并准备了 T2V(文本生成视频)、I2V(图像生成视频)、R2V(参照素材生成视频)三种工作流。
此前的文章介绍过,视频用的 VAE「H3-VisualVAE」在空间方向压缩 16 倍、时间方向压缩 4 倍,并通过 int8 convrot 量化与自定义内核来压低显存占用。
本次改动针对的是 8 月开放权重(open weights)版本在 ComfyUI 侧的实现改良。改动对象不是模型本体,而是负责把视频转换到潜在空间再还原的 VAE:编码最高约提速 2.2 倍,解码提速约 1.4〜2.7 倍。int8 convrot 版的 VAE 文件仍在继续使用,解码器在这基础上进一步提速。
据官方说明,在 1344×768、129 帧的视频上,编码与解码合计的耗时从 24.3 秒缩短到 12.7 秒。视频生成除采样之外还要花 VAE 的处理时间,因此试错次数越多,这部分累积得越明显。
改动内容
提速由三处改动构成。
编码器的融合内核(默认启用)
此前编码器在卷积之间,要分别执行逐帧归一化、激活函数与边缘填充,每一步都要读写数百 MB 量级的数据;现在这些处理被合并成一次,并按下一层卷积所需的内存布局直接写出。
仅这一项就带来约 1.5 倍提速,输出与原来完全一致。无需任何设置,更新后即自动生效。
卷积开始支持 --fast fp16_accumulation
PyTorch 把卷积交给 NVIDIA 的 cuDNN 库处理,而经由 cuDNN 无法指定 fp16 累加,因此这个选项过去只对矩阵运算有效,无法给编码器提速。
这次 ComfyUI 自备了卷积实现,并把偏置与跳跃连接一并纳入同一套处理,使该选项能够生效。配合融合内核,编码器约提速 2.2 倍。
int8 解码器
使用 int8 版 VAE 文件时,解码器权重以 8 位处理。把归一化、激活函数与跳跃连接并入矩阵运算之后,中间结果就不必写回内存;注意力同样以 8 位计算。
官方称相比此前的 int8 VAE 提速 1.4 倍。
实测结果
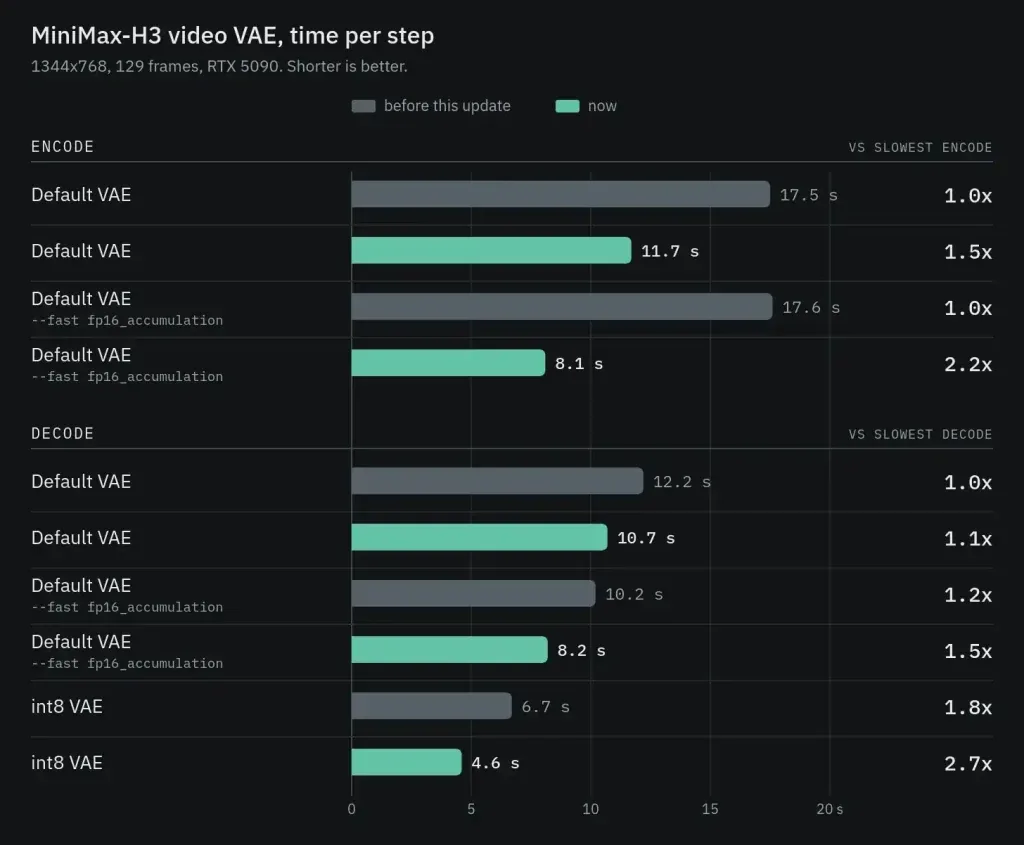
测试在 RTX 5090、1344×768、129 帧的条件下进行,各配置都与更新前的同一配置对比。官方称所有测试都在同一天、通过 VAE Encode 与 VAE Decode 节点完成。
- 融合内核:由于减少了内存读写,官方称效果不限于 RTX 5090,NVIDIA 显卡普遍受益。
--fast fp16_accumulation:对能以倍速执行 fp16 累加的消费级显卡有效。
另外,该说明以 NVIDIA 显卡为前提,未提及 AMD 显卡或 Apple Silicon 上的效果。
对画质的影响
官方称提速带来的画质变化几乎看不出差异。
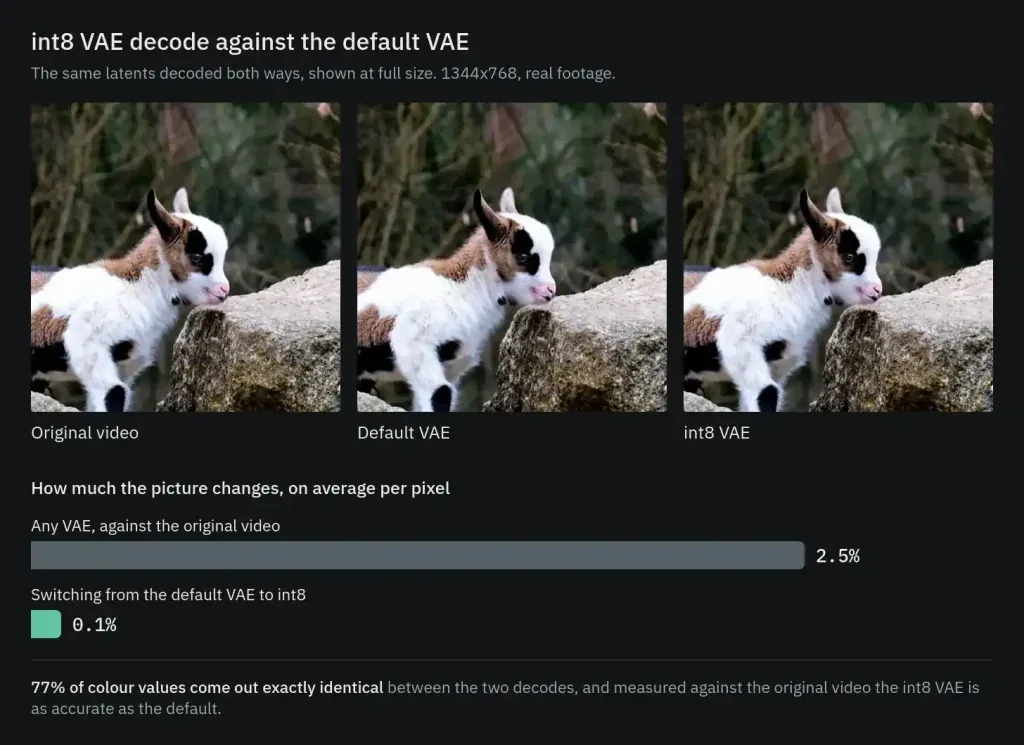
对比同一帧画面在原视频、标准 VAE 与 int8 VAE 下的表现。经 VAE 处理后画面相对原视频平均变化 2.5%,切换到 int8 后再变化 0.1%;两种解码结果中有 77% 的颜色值完全一致。
VAE 在压缩再还原视频的过程中本来就会损失少量细节;int8 高速处理额外引入的误差,约为这部分损失的 1/30。
从数值上看
与标准解码器相比,int8 解码器的 PSNR 为 67.7dB,提速后的编码器约为 68dB。作为对照,实拍视频经 VAE 还原时的 PSNR 约为 38dB。此外,即便使用 int8 版 VAE,编码仍以 fp16 进行;融合内核只是改变了计算顺序,结果不变。
使用方法
- 把 ComfyUI 更新到 v0.36.0 以上:仅此一步即可启用编码器的融合内核。
- 在启动参数中加上
--fast fp16_accumulation:可进一步加速编码器与解码器。 - 载入 int8 版 VAE 文件:解码速度最快,官方称可以直接替换标准 VAE 文件使用。
工作流也可以从 ComfyUI 的模板库中获取。
| I2V | video_minimax_h3_i2v.json |
|---|---|
| R2V | video_minimax_h3_r2v.json |
| T2V | video_minimax_h3_t2v.json |
| int8 VAE | minimax_h3_video_vae_int8_convrot.safetensors |
【Tips】关于启动选项
--fast fp16_accumulation 是对整个 ComfyUI 生效的启动选项。官方说明指出,它此前也已作用于矩阵运算,因此在该模型之外的模型上,计算精度的处理方式同样会改变。若在其他模型上感觉输出有异样,可以去掉该选项做对比。
本次说明涉及的对象仅为视频 VAE,未提及音频用的 VAE。
参考来源:Making the MiniMax H3 Video VAE 2x Faster
更多同类内容见站内 AI 资讯 栏目。


暂无评论内容